→
Q
NVIDIA B300 100장을 운영하려면 서버가 몇 대 필요한가?
DGX B300은 한 시스템에 GPU 8장을 탑재한다. DGX 단위로 구성하면 12대는 96장, 13대는 104장이므로 실제 설계는 서버와 랙 단위로 맞춘다.
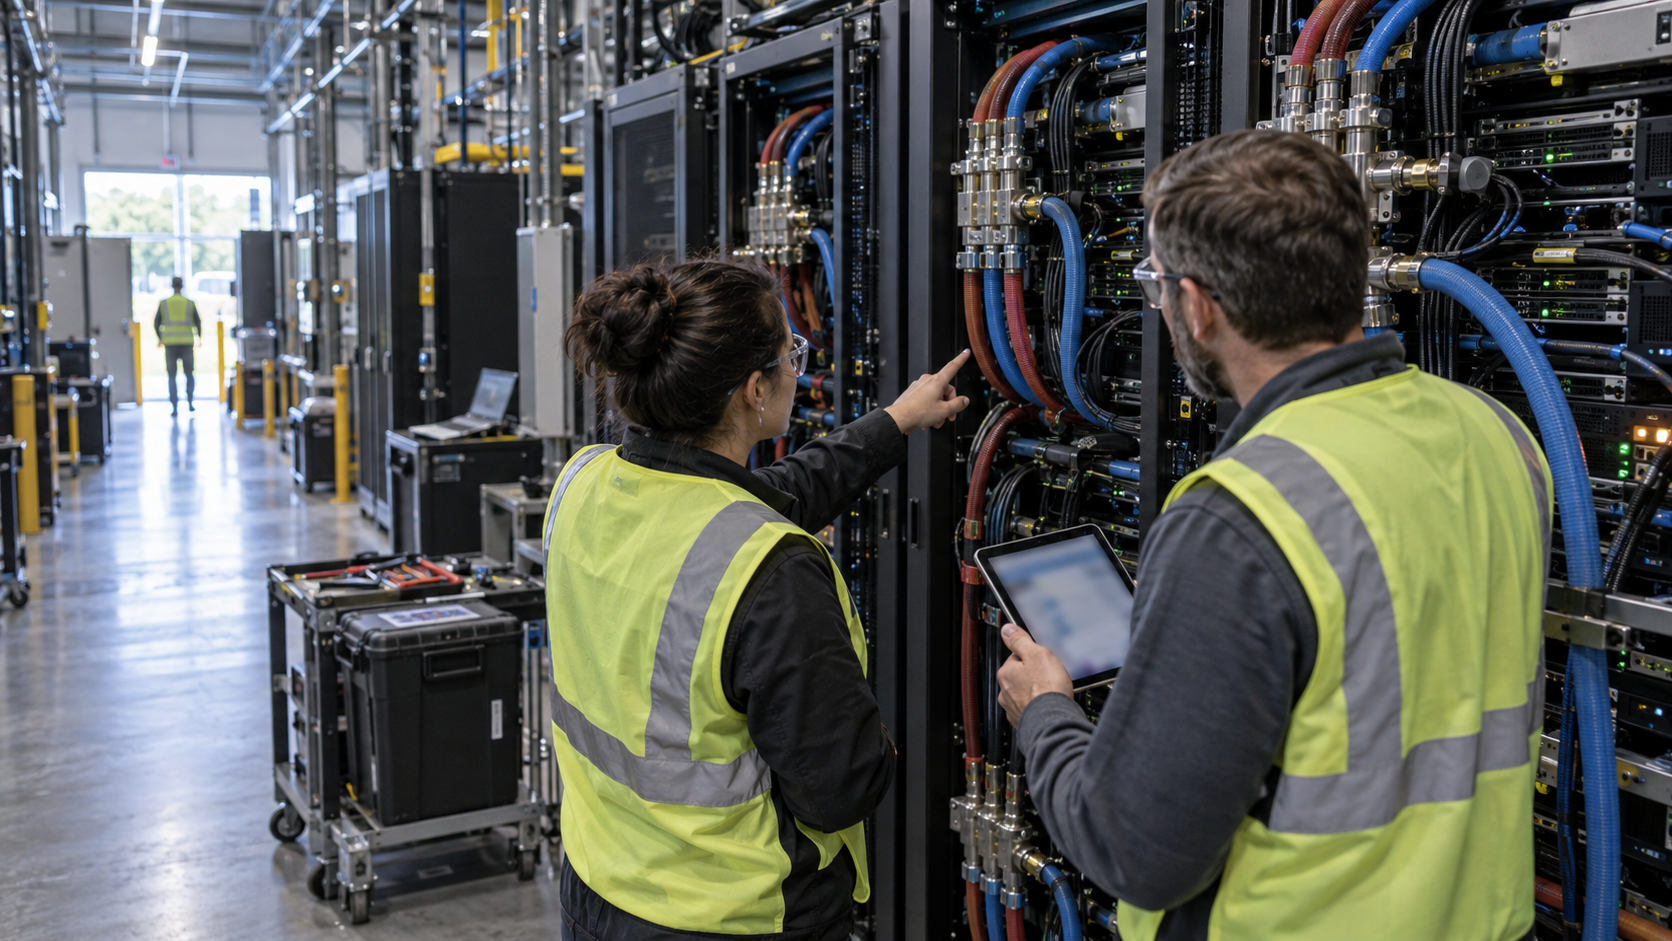
Blackwell Ultra 대규모 클러스터에서 진짜 어려운 일은 계산이 아니라 장애를 찾고 복구하는 운영이다
개인 프로젝트에 NVIDIA B300 100장이 주어진다면 그 경험만으로도 경쟁력이 될까. 커뮤니티에서는 고성능 GPU를 대규모로 운영한 이력이 모델 개발 경험보다 희소할 수 있다는 의견이 나왔다. 답을 찾으려면 GPU 성능보다 100장이 동시에 실패하는 방식을 살펴봐야 한다.
NVIDIA DGX B300 한 대에는 Blackwell Ultra GPU 8장과 2.1TB GPU 메모리가 들어간다. 시스템 한 대의 소비전력은 약 14kW이고 크기는 10U다. DGX 구성을 따르면 12대는 96장, 13대는 104장이 된다. 따라서 ‘정확히 100장’보다 랙과 노드 단위로 설계하게 된다. (nvidia.com)
DGX B300 13대만 계산해도 장비 전력은 약 182kW다. 여기에는 냉각과 네트워크, 스토리지, 관리 서버의 전력이 빠져 있다. GPU를 확보하는 순간 프로젝트는 머신러닝 실험이 아니라 데이터센터 운영 문제가 된다.
랙 스케일 제품인 GB300 NVL72를 보면 이 차이가 더 선명하다. GPU 72장을 하나의 NVLink 도메인으로 묶고 랙당 최대 142kW의 전력을 사용한다. 누수 감지 장치와 여덟 개의 전원 선반까지 기본 설계에 포함된다. (docs.nvidia.com)
100장을 운영한 경력이 희소한 이유는 비싼 카드를 만졌기 때문이 아니다. 전력과 냉각, 패브릭, 드라이버, 학습 코드를 하나의 시스템으로 다뤄야 하기 때문이다.
논의 과정에서는 네이버가 보안 모델에 GPU 3천장을 쓴다는 이야기가 나왔다. 하지만 2026년 9월 3일 네이버 공식 발표에 적힌 규모와 기종은 다르다. 네이버클라우드는 보유한 B200 4천장을 선제 투입하고 LG의 H200 256장과 정부 제공 물량 256장을 별도로 활용한다고 밝혔다. B300 3천장으로 확인된 사업은 아니다. (navercorp.com)
목표는 하이퍼클로바X와 엑사원을 기반으로 700B급 MoE 보안 모델 두 개를 병렬 개발하는 것이다. 약 830TB의 데이터를 사용해 전력·금융·통신·방위산업 등 일곱 분야에서 검증할 계획이다. 폐쇄망 운용도 개발 범위에 포함됐다. (navercorp.com)
중요한 숫자는 4천장만이 아니다. 서로 다른 기반 모델과 데이터 흐름을 분리한 채 대규모 작업 두 개를 같은 일정 안에 끝내야 한다. 전용 자원을 받더라도 실험 우선순위와 장애 격리, 체크포인트 보존 문제는 사라지지 않는다.
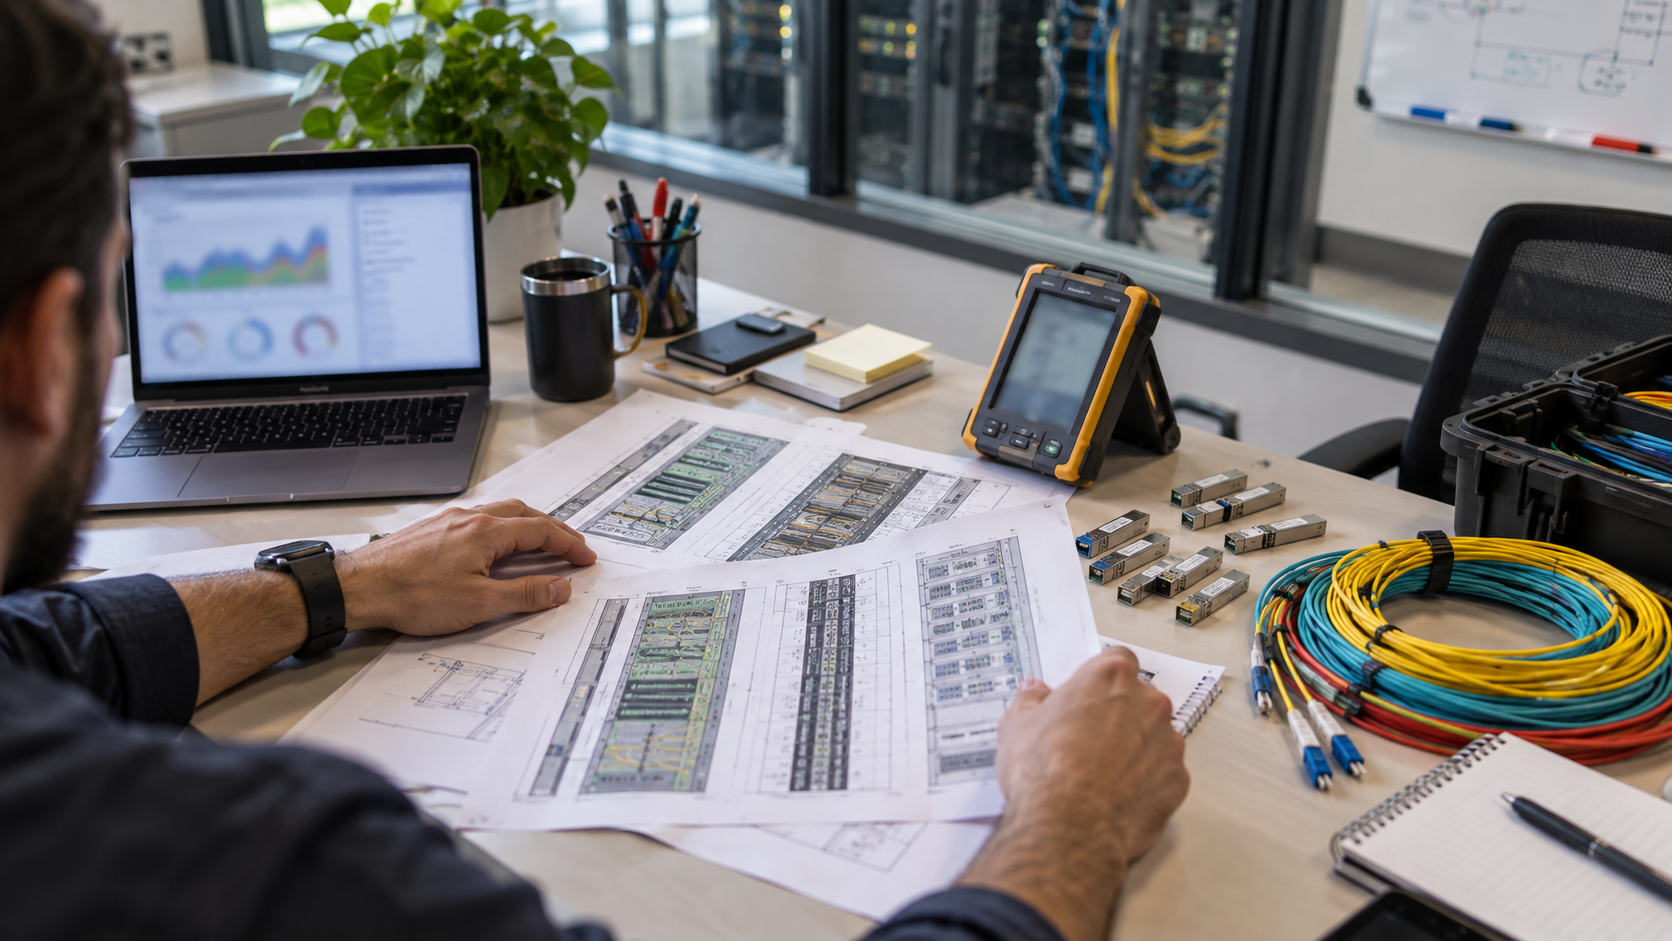
실제 작업은 장비 등록과 검증부터 시작한다. 노드별 GPU·NIC·NVLink 토폴로지와 드라이버 버전을 맞춘다. 그런 다음 DCGM과 NCCL 진단으로 GPU 간 통신과 노드 간 대역폭을 검사한다. NVIDIA NCCL은 작업 시작 전에 P2P 경로와 InfiniBand 대역폭을 확인하는 진단 기능을 제공한다. (docs.nvidia.com)
다음 단계에서는 작업 실행 환경을 고정한다. NVIDIA의 B300 SuperPOD 구조는 사전학습에 Slurm을, Kubernetes 워크로드에는 NVIDIA Run:AI를 제시한다. 학습 코드와 CUDA 라이브러리는 컨테이너 이미지로 묶는다. 데이터 경로·노드 수·GPU 수·병렬화 설정은 작업 파일에 남긴다. (docs.nvidia.com)
세 번째 단계에서는 작은 규모로 통신 경로를 검증한다. 단일 노드에서 시작해 2개, 4개 노드로 늘리면서 처리량과 손실 곡선을 비교한다. 써본 사람들 사이에서는 처음부터 전체 클러스터를 점유하면 느린 노드 하나와 NCCL 설정 오류를 구분하기 어렵다는 반응이 많다.
마지막은 복구 설계다. 대규모 학습에서는 모델 가중치뿐 아니라 옵티마이저 상태와 메타데이터도 여러 노드에 나눠 저장한다. NVIDIA NeMo의 분산 체크포인트는 작업 상태를 여러 GPU나 노드에 나눠 저장한다. (docs.nvidia.com)
운영 화면에 GPU 사용률 100%가 떠도 클러스터가 건강하다고 단정할 수는 없다. 온도와 전력 제한, ECC 오류, NVLink 재전송, 네트워크 대역폭, 작업별 처리량을 함께 봐야 한다. DCGM Exporter는 이런 정보를 Prometheus로 보낸다. 이를 이용하면 GPU와 NVSwitch 상태를 지속적으로 감시할 수 있다. (docs.nvidia.com)
운영자의 실력은 장애가 났을 때 드러난다. 특정 노드를 빼고 작업을 재개했는지, 체크포인트가 실제로 복원됐는지, 느린 rank를 찾아냈는지를 기록해야 한다. 정상 실행 한 번보다 복구 시간과 재현 절차가 더 강한 경력 자료가 된다.
개인 개발자나 소규모 팀이 B300 100장을 직접 확보할 가능성은 낮다. 그래도 이 운영 방식은 2개 노드나 단기 클라우드 환경에서도 연습할 수 있다. 컨테이너 이미지와 Slurm 작업 파일, DCGM 대시보드, 분산 체크포인트, 장애 보고서를 한 묶음으로 남기면 규모가 커져도 같은 절차를 확장할 수 있다.
B300 100장을 제공받는 일은 분명 드문 기회다. 다만 GPU를 할당받아 학습 명령만 실행했다면 희소성은 장비 소유자에게 남는다. 용량 계획부터 패브릭 검증, 스케줄링, 관측, 장애 복구까지 책임졌다면 이야기는 달라진다.
대규모 GPU 경력에서 물어야 할 것은 ‘몇 장을 썼나’가 아니다. ‘한 장이 멈췄을 때 나머지 99장의 시간을 얼마나 지켰나’다.
DGX B300은 한 시스템에 GPU 8장을 탑재한다. DGX 단위로 구성하면 12대는 96장, 13대는 104장이므로 실제 설계는 서버와 랙 단위로 맞춘다.
B300은 Blackwell Ultra GPU를 가리키며 DGX B300 같은 서버에 탑재된다. GB300 NVL72는 Grace CPU와 B300 GPU 72장을 NVLink로 연결한 액체냉각 랙 스케일 시스템이다.
Slurm 또는 Kubernetes 기반 스케줄링, NCCL 네트워크 진단, DCGM 관측, 분산 체크포인트와 자동 복구가 핵심이다. GPU 사용률보다 장애를 격리하고 학습을 재개하는 능력이 중요하다.